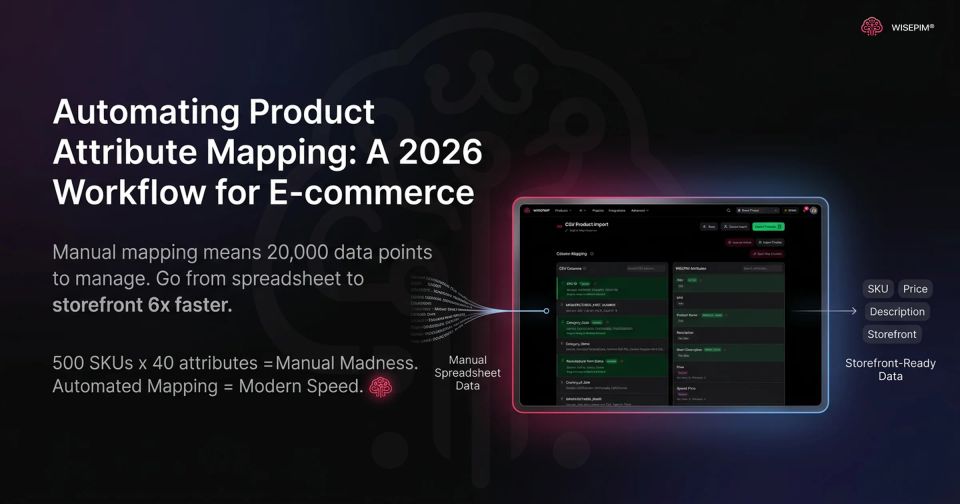
Un catalogue de 500 SKU avec 40 attributs par produit, c'est 20 000 données individuelles que quelqu'un doit maintenir exactes. Si ton équipe s'appuie sur des tableurs manuels pour mapper ces champs depuis les feeds fournisseurs vers ta boutique, tu avances bien plus lentement que les concurrents qui utilisent des systèmes dédiés. Des données mal mappées provoquent directement des recherches sans résultat, qui entraînent l'abandon immédiat du site.
Les e-commerçants reçoivent des informations de centaines de fournisseurs dans des formats extrêmement différents. Un fournisseur livre un fichier CSV impeccable avec l'en-tête de colonne « Composition ». Un autre envoie un PDF où le type de tissu est enfoui dans un énorme bloc de texte. Un troisième utilise un feed API qui nomme exactement la même donnée « Material ».
Résoudre ces écarts est au cœur du mapping des attributs. Il s'agit de traduire le jargon des fournisseurs dans ta taxonomie produit interne, puis de retraduire ces données pour des destinations externes comme Shopify ou Amazon.
Construire une matrice de mapping robuste
Avant de toucher au moindre logiciel, il te faut une matrice de mapping centralisée. Ce document sert de couche de traduction pour toute la gestion de ton catalogue. Il définit précisément comment les données externes se convertissent dans ton schéma interne.
Une matrice pratique comprend le nom du champ source, l'attribut interne cible, le format de données accepté et les éventuelles règles de transformation. Si un fournisseur indique le poids en onces mais que ta boutique affiche des grammes, la matrice définit la formule de conversion. Fixer ces règles dès le départ évite les erreurs en aval qui déroutent les acheteurs et font grimper les taux de retour.
Exemples de lignes d'une matrice de mapping, construites à partir des cas de cet article
| « Composition » | En-tête de colonne CSV | Material | Mapper l'en-tête vers Material |
|---|---|---|---|
| Type de tissu dans un bloc de texte | PDF fournisseur | Material | Extraire la valeur du texte |
| « Material » | Champ du feed API | Material | Mapper le champ vers Material |
| Poids en onces | Feed fournisseur | Poids (grammes) | Convertir les onces en grammes |
| « Small », « s », « S » | Feeds fournisseurs | Taille | Normaliser en « S » |
| « Navy/Midnight » | ERP interne | Amazon Color Map | Envoyer « Blue » |
Le piège de la sur-ingénierie
Les responsables catalogue tombent souvent dans le piège de la sur-ingénierie de leurs schémas. Ils créent 50 champs personnalisés pour une seule catégorie, pour se rendre compte que les clients ne filtrent que sur cinq : prix, taille, couleur, marque et matière.
Des schémas surchargés gaspillent les ressources de la base de données et freinent fortement l'onboarding. Quand tu mappes des attributs en pensant à la montée en charge, concentre-toi sur les champs qui alimentent réellement la recherche sémantique et le filtrage à facettes. Les moteurs de recherche e-commerce modernes s'appuient fortement sur l'intention. Si un utilisateur cherche « sacoche ordinateur écoresponsable », le moteur associe cette requête à des attributs structurés comme « durable » ou « matière recyclée ». Si tu as mappé ces données fournisseur dans une description texte générique au lieu d'un attribut produit spécifique, ton produit n'apparaîtra pas dans les résultats.
Résoudre les incohérences de taxonomie entre canaux
Mapper un catalogue maître vers différents canaux de vente ajoute une couche de complexité. Ton ERP interne peut indiquer la couleur d'une veste comme « Navy/Midnight », alors qu'Amazon exige une valeur « Color Map » stricte : « Blue ».
Mal mapper ces variantes casse les relations parent-enfant entre produits. Pense aux intégrations qui récupèrent des données de plateformes comme AliExpress vers des systèmes back-office comme Odoo. Extraire la taille, la couleur et le style d'un seul SKU dans une hiérarchie de variantes structurée demande des règles de mapping précises. Sans elles, tu te retrouves avec des annonces fragmentées. Les entreprises qui misent sur un mapping exact fixent les bonnes attentes chez les clients, et cela veut dire moins de retours produits.
Le passage à l'ingestion automatisée
Le secteur a dépassé le simple mapping à base de règles. Début 2026, une part croissante des organisations utilise l'AI pour l'enrichissement des données produit et le mapping intelligent des champs.
Au lieu d'écrire des formules regex complexes pour analyser les données fournisseurs, les outils modernes utilisent le traitement du langage naturel pour ingérer du texte non structuré. Tu peux déposer un PDF fournisseur brut dans un système, et l'AI analyse le document, normalise les valeurs incohérentes (convertir « Small », « s » et « S » en un « S » standardisé) et les mappe directement vers tes tables de base de données prédéfinies.
WISEPIM applique la même idée à la gestion des attributs. L'enrichissement par AI lit tes titres produit, tes descriptions et tes données fournisseurs et place les bonnes valeurs dans les bons champs d'attributs, et les imports mappent les colonnes fournisseurs vers tes propres champs. Tu te passes entièrement du copier-coller manuel.
Pourquoi la validation humaine reste nécessaire
L'automatisation totale est un mythe. S'appuyer entièrement sur l'AI sans validation humaine dans la boucle mène inévitablement à des erreurs de catalogue coûteuses. Un système automatisé peut interpréter un attribut de conditionnement « lot de 10 » comme le prix d'un article unique, et anéantir ta marge sur ce SKU.
Les workflows de mapping intelligents confient le gros du travail à l'AI (extraction et standardisation des données brutes), tandis que les responsables catalogue s'occupent de la validation des données produit. Tu examines les mappings proposés par l'AI, tu approuves ceux qui sont exacts et tu corriges les exceptions. Cette approche hybride réduit fortement les cycles de revue manuelle tout en préservant une intégrité parfaite des données.
Mapping hybride des attributs : l'AI propose, les responsables catalogue décident
Pressions réglementaires : le DPP européen
Le mapping des attributs n'est plus seulement une fonction marketing. La mise en œuvre élargie du passeport numérique des produits (DPP) de l'Union européenne tout au long de 2026 a fait de la gouvernance des données une stricte obligation de conformité légale.
Les marques qui vendent dans l'UE doivent désormais suivre et publier des attributs extrêmement détaillés sur l'origine des produits, leur réparabilité et leur impact environnemental. Impossible de suivre manuellement un tel volume de données granulaires sur des milliers de SKU. Des pipelines de mapping automatisés sont indispensables pour extraire les données de conformité des spécifications fabricant et les envoyer dans les formats réglementaires requis.
Arrête de mapper à la main
Le mapping manuel des attributs est le principal goulot d'étranglement des lancements de nouveaux produits. En automatisant la façon dont tu ingères et routes les données fournisseurs, ton équipe passe d'une posture défensive, à corriger sans cesse des erreurs, à une stratégie offensive qui lance les SKU plus vite.
Transforme ta gestion de données complexe en une opération simple. WISEPIM te permet de créer et mapper ton contenu produit si vite qu'on dirait de la triche. Commence à router intelligemment les données de tes fournisseurs et récupère le temps de ton équipe.