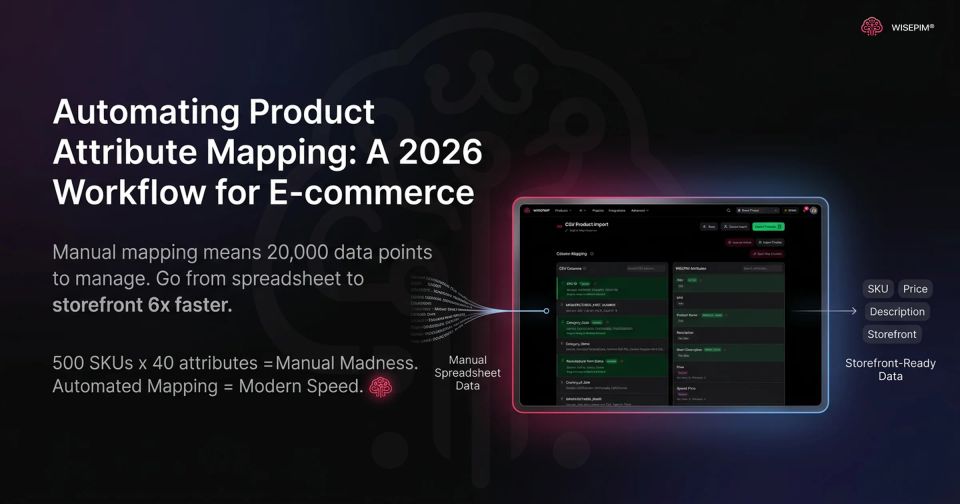
Ein Katalog mit 500 SKUs und 40 Attributen pro Produkt bedeutet 20.000 einzelne Datenpunkte, die jemand korrekt halten muss. Wenn dein Team diese Felder per Tabellenkalkulation von Lieferanten-Feeds auf deinen Shop mappt, bist du weit langsamer als Wettbewerber mit spezialisierten Systemen. Schlecht gemappte Daten führen direkt zu Suchen ohne Ergebnis und damit zu sofortigen Absprüngen.
Händler erhalten Informationen von Hunderten Anbietern in völlig unterschiedlichen Formaten. Ein Lieferant liefert eine makellose CSV-Datei mit der Spaltenüberschrift „Composition“. Ein anderer schickt ein PDF, in dem die Stoffart tief in einem riesigen Textblock versteckt ist. Ein dritter nutzt einen API-Feed, der genau denselben Datenpunkt „Material“ nennt.
Diese Abweichungen aufzulösen, ist der Kern von Attribut-Mapping. Dabei übersetzt du den Jargon der Anbieter in deine interne Produkttaxonomie und anschließend wieder für externe Endpunkte wie Shopify oder Amazon.
Eine belastbare Mapping-Matrix aufbauen
Bevor du irgendeine Software anfasst, brauchst du eine zentrale Mapping-Matrix. Dieses Dokument ist die Übersetzungsschicht für deinen gesamten Katalogbetrieb. Es legt genau fest, wie externe Datenpunkte in dein internes Schema überführt werden.
Eine praxistaugliche Matrix enthält den Namen des Quellfelds, das interne Zielattribut, das zulässige Datenformat und alle Transformationsregeln. Liefert ein Lieferant das Gewicht in Unzen, dein Shop zeigt aber Gramm an, gibt die Matrix die Umrechnungsformel vor. Wer diese Regeln vorab festlegt, verhindert spätere Fehler, die Käufer verwirren und Retourenquoten in die Höhe treiben.
Beispielzeilen einer Mapping-Matrix, gebaut aus den Beispielen in diesem Beitrag
| „Composition“ | CSV-Spaltenüberschrift | Material | Überschrift auf Material mappen |
|---|---|---|---|
| Stoffart in einem Textblock | Lieferanten-PDF | Material | Wert aus dem Text extrahieren |
| „Material“ | Feld im API-Feed | Material | Feld auf Material mappen |
| Gewicht in Unzen | Lieferanten-Feed | Gewicht (Gramm) | Unzen in Gramm umrechnen |
| „Small“, „s“, „S“ | Lieferanten-Feeds | Größe | Auf „S“ normalisieren |
| „Navy/Midnight“ | Internes ERP | Amazon Color Map | „Blue“ senden |
Die Over-Engineering-Falle
Katalogmanager tappen oft in die Falle, ihre Schemas zu überladen. Sie bauen 50 eigene Felder für eine einzige Kategorie, nur um festzustellen, dass Kunden ausschließlich nach fünf filtern: Preis, Größe, Farbe, Marke und Material.
Aufgeblähte Schemas verschwenden Datenbankressourcen und bremsen das Onboarding massiv aus. Konzentriere dich beim skalierbaren Attribut-Mapping auf die Felder, die semantische Suche und Facettenfilter tatsächlich antreiben. Moderne E-Commerce-Suchmaschinen setzen stark auf Suchintention. Sucht jemand nach „umweltfreundliche Laptoptasche“, ordnet die Suchmaschine diese Anfrage strukturierten Attributen wie „nachhaltig“ oder „recyceltes Material“ zu. Hast du diese Lieferantendaten in eine allgemeine Textbeschreibung gemappt statt in ein konkretes Produktattribut, erscheint dein Produkt nicht in den Ergebnissen.
Taxonomie-Abweichungen zwischen Kanälen auflösen
Einen Master-Katalog auf verschiedene Vertriebskanäle zu mappen, bringt eine weitere Ebene an Komplexität. Dein internes ERP führt eine Jackenfarbe vielleicht als „Navy/Midnight“, Amazon verlangt aber einen strikten „Color Map“-Wert „Blue“.
Werden diese Varianten nicht korrekt gemappt, brechen Eltern-Kind-Beziehungen zwischen Produkten. Denk an Integrationen, die Daten von Plattformen wie AliExpress in Backend-Systeme wie Odoo ziehen. Um Größe, Farbe und Stil einer einzelnen SKU in eine strukturierte Variantenhierarchie zu überführen, braucht es präzise Mapping-Regeln. Ohne sie landest du bei zersplitterten Listings. Unternehmen, die auf genaues Mapping setzen, wecken die richtigen Erwartungen bei Kunden, und das bedeutet weniger Retouren.
Der Wechsel zur automatisierten Datenaufnahme
Die Branche ist über einfaches regelbasiertes Mapping hinaus. Anfang 2026 nutzt ein wachsender Anteil der Unternehmen AI für Produktdatenanreicherung und intelligentes Feld-Mapping.
Statt komplexe Regex-Formeln zu schreiben, um Anbieterdaten auszuwerten, nutzen moderne Tools Natural Language Processing, um unstrukturierten Text aufzunehmen. Du kannst ein rohes Lieferanten-PDF ins System ziehen, und die AI wertet das Dokument aus, normalisiert uneinheitliche Werte (aus „Small“, „s“ und „S“ wird ein einheitliches „S“) und mappt sie direkt auf deine vordefinierten Datenbanktabellen.
WISEPIM wendet dieselbe Idee auf die Attributverwaltung an. Die AI-Anreicherung liest deine Produkttitel, Beschreibungen und Lieferantendaten und trägt die richtigen Werte in die richtigen Attributfelder ein, und Importe mappen Lieferantenspalten auf deine eigenen Felder. Das manuelle Copy-and-paste fällt komplett weg.
Warum menschliche Prüfung weiterhin nötig ist
Vollständige Automatisierung ist ein Mythos. Wer sich ganz auf AI verlässt, ohne Human-in-the-Loop-Prüfung, produziert zwangsläufig teure Katalogfehler. Ein automatisiertes System könnte ein Verpackungsattribut „10er-Pack“ als Einzelstückpreis missverstehen und damit deine Marge bei dieser SKU vernichten.
Clevere Mapping-Workflows lassen die AI die schwere Arbeit machen (Rohdaten extrahieren und standardisieren), während Katalogmanager die Produktdatenvalidierung übernehmen. Du prüfst die vorgeschlagenen Mappings der AI, gibst die korrekten frei und korrigierst die Ausnahmen. Dieser hybride Ansatz reduziert manuelle Prüfzyklen drastisch und erhält gleichzeitig perfekte Datenintegrität.
Hybrides Attribut-Mapping: AI schlägt vor, Katalogmanager entscheiden
Regulatorischer Druck: der EU-DPP
Attribut-Mapping ist längst nicht mehr nur eine Marketingaufgabe. Die breitere Einführung des Digitalen Produktpasses (DPP) der Europäischen Union im Laufe des Jahres 2026 hat Data Governance zu einer strikten rechtlichen Compliance-Anforderung gemacht.
Marken, die in der EU verkaufen, müssen jetzt hochdetaillierte Attribute zu Herkunft, Reparierbarkeit und Umweltwirkung ihrer Produkte erfassen und offenlegen. Diese Menge an granularen Daten über Tausende SKUs hinweg kannst du nicht manuell nachverfolgen. Automatisierte Mapping-Pipelines sind Pflicht, um Compliance-Daten aus Herstellerspezifikationen zu extrahieren und in die vorgeschriebenen regulatorischen Formate zu überführen.
Schluss mit manuellem Mapping
Manuelles Attribut-Mapping ist der größte Engpass bei neuen Produktlaunches. Wenn du automatisierst, wie du Anbieterdaten aufnimmst und weiterleitest, wechselt dein Team von der Defensive (ständig Fehler beheben) in die Offensive: SKUs schneller launchen.
Mach aus komplexem Datenmanagement einen einfachen Ablauf. Mit WISEPIM erstellst und mappst du Produktinhalte so schnell, dass es sich wie Schummeln anfühlt. Leite deine Anbieterdaten intelligent weiter und hol dir die Zeit deines Teams zurück.