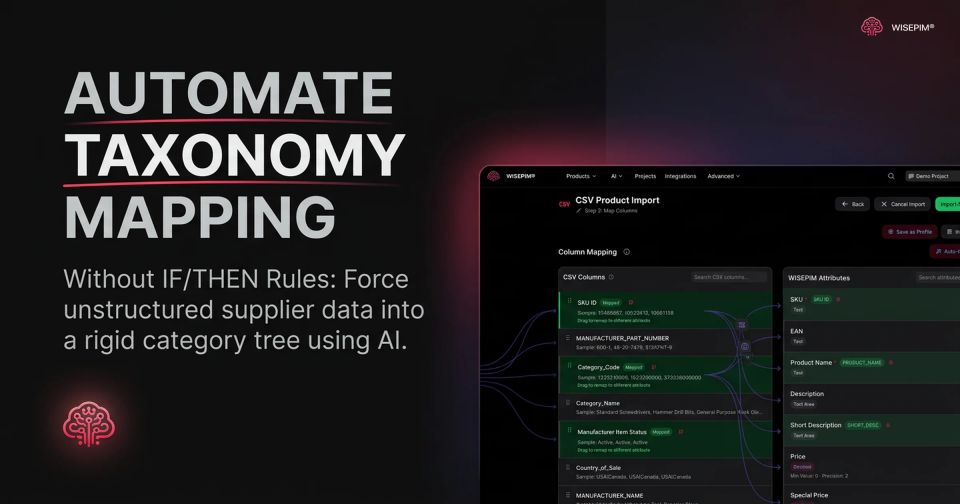
Les systèmes déconnectés et les silos de données coûtent un vrai chiffre d'affaires aux entreprises e-commerce. Une grande partie de cette fuite se produit tout au début du cycle de vie du catalogue : quand on essaie de faire entrer des données fournisseurs désordonnées et non structurées dans une arborescence de catégories rigide. Prends le secteur de l'alimentation au Royaume-Uni, en ce moment même en 2026, où une grande part des ventes provient de marques de distributeur souvent dépourvues d'identifiants produit universels comme les GTIN ou les EAN. Impossible de compter sur une recherche par code-barres. Il faut lire la description, comprendre le contexte et mapper le produit avec précision.
Les organisations d'hier géraient cela avec d'immenses tableurs fragiles. Les équipes e-commerce modernes l'automatisent.
Le marché mondial du PIM continue de croître, porté en grande partie par le passage de la saisie manuelle à une compréhension sémantique automatisée. Les e-commerçants dotés de taxonomies propres et pilotées par l'AI tirent davantage de la recherche à facettes, tout simplement parce que leurs filtres fonctionnent vraiment.
Voici précisément comment arrêter d'écrire des règles manuelles et commencer à automatiser la classification de tes produits.
La fin des tables de dépendances
Pendant des années, mapper les données fournisseurs vers ta taxonomie produit interne voulait dire écrire des instructions IF/THEN à n'en plus finir. Si le titre contient « shirt », mapper vers « Apparel ». Si la description contient « length 50 cm », extraire « 50 » et le mapper vers l'attribut « Length ».
Cette approche à base de règles casse dès qu'un fournisseur envoie « iPhone 12 64GB Blue » et un autre « Apple iPhone 12 - 64 GB, Color: Blue ». Les systèmes classiques les traitent comme deux SKU différents. Ton stock se fragmente. Des annonces en double apparaissent.
Le secteur est passé aux grands modèles de langage (LLM) et au traitement du langage naturel (NLP). Ces modèles comprennent le contexte sémantique. Ils savent que « athleisure » correspond à « pantalon de yoga » ou « vêtements de sport » sans qu'un humain ait à construire ce lien explicitement. Ce changement supprime de fait le besoin de règles de transformation des données produit manuelles qui demandent une maintenance constante.
Étape par étape : automatiser le mapping de taxonomie
Automatiser ta classification demande un enchaînement précis d'opérations. Passer directement au modèle AI mène généralement à des hallucinations affirmées avec aplomb.
Les quatre étapes du mapping de taxonomie automatisé
Étape 1 : prétraiter et standardiser les données d'entrée
Les data scientists du secteur e-commerce te le diront : nettoyer les données d'entrée améliore bien plus le taux de correspondance que de passer au dernier modèle AI.
Les e-commerçants reçoivent des données produit dans des formats extrêmement hétérogènes. Tu peux recevoir un fichier Excel brouillon d'un fournisseur et un feed XML mal formaté d'un autre. Avant tout mapping, lance un script de prétraitement pour supprimer les balises HTML, standardiser les unités de mesure (convertir « inches » en « in ») et normaliser la casse du texte. Des données propres donnent au moteur de classification une base claire.
Étape 2 : déployer l'extraction de contexte multimodale
Se fier uniquement au texte est une erreur. Les systèmes les plus avancés utilisent une AI multimodale pour analyser simultanément les titres, descriptions, images fournisseurs et avis clients.
Si la description fournisseur dit simplement « Classic Blue V-Neck », le modèle texte risque de le classer dans les t-shirts homme. En analysant l'image fournisseur jointe, un modèle multimodal reconnaît un pull en cachemire pour femme. Combiner l'analyse visuelle et le traitement du texte détecte des erreurs que le texte seul laisse passer.
Étape 3 : exécuter le mapping sémantique des attributs
Une fois le contexte établi, le système mappe les données extraites vers ta hiérarchie spécifique. Des outils comme getName.ai jouent le rôle de « mapping killers » à ce stade.
Au lieu de s'appuyer sur des tables rigides, un PIM sémantique lit une expression comme « étanche jusqu'à 50 m » et l'affecte automatiquement comme attribut numérique avec unité au bon champ de la base. C'est particulièrement crucial pour mapper des données fournisseurs non structurées directement vers des standards mondiaux comme GS1, ECLASS ou ETIM pour le matériel électrotechnique. L'AI comprend les exigences de la destination et formate les données en conséquence.
Étape 4 : mettre en place un workflow human-in-the-loop
L'AI est un outil puissant, pas de la magie. Elle excelle dans les premiers jets à grande échelle et dans les mises en forme répétitives. Elle manque de jugement métier pour les cas limites complexes.
Le cadre opérationnel dominant est le Human-in-the-Loop (HITL). Tu configures le système pour automatiser 95 % du mapping du catalogue sur la base de scores de confiance élevés. Les 5 % de produits ambigus restants sont automatiquement envoyés à des merchandisers humains pour revue. Des services natifs comme SAP AI Data Attribute Recommendation associent un score de confiance à chaque prédiction, ce qui indique précisément à ton équipe quand faire confiance à la machine et quand vérifier le résultat.
Le ROI du mapping automatisé
Les cadres théoriques ne comptent que s'ils produisent des résultats business concrets.
Prends LemonMind, une agence qui a récemment mené une migration PIM d'envergure. Son client devait faire passer 500 000 produits d'une structure de catégories obsolète vers une taxonomie entièrement revue. Reclasser manuellement un demi-million de SKU prend des mois. Grâce à l'AI, l'agence a automatisé le mapping avec un taux d'efficacité de 95 %. Il ne restait que 25 000 produits en cas limite à revoir par des humains, ce qui a économisé des milliers d'heures de travail manuel.
Amantra, un e-commerçant international avec plus d'un million de SKU, faisait face au même goulot d'étranglement avec des imports fournisseurs incomplets. Il a mis en place un moteur de classification basé sur un LLM qui analysait le texte non structuré, enrichissait les métadonnées manquantes et attribuait les catégories selon le contexte. Le système a géré avec succès son catalogue multilingue et s'est adapté aux évolutions saisonnières de la taxonomie sans nécessiter une seule mise à jour manuelle de règle.
Quand un client filtre ton site sur « Imperméable » et qu'une veste n'a pas cet attribut, elle n'existe tout simplement pas. C'est une pure fuite de chiffre d'affaires. Mettre en place un mapping des attributs piloté par l'AI colmate cette fuite et supprime une grande partie du travail manuel de mapping des catégories.
Retour à la réalité : limites et risques
L'automatisation comporte des risques. Tu dois les comprendre avant de déployer ces systèmes à grande échelle.
Les sceptiques ont raison de rappeler la réalité du « garbage in, garbage out ». Les modèles AI dépendent fortement de leurs données d'entraînement. Si les données d'entrée d'un fournisseur sont fondamentalement erronées, l'AI classera mal le produit avec assurance.
De plus, les LLM généralistes souffrent d'une sérieuse méconnaissance des domaines B2B. Dans des secteurs spécialisés comme les composants électriques, les matériaux de construction ou les dispositifs médicaux, l'AI comprend souvent mal le jargon technique. Un t-shirt grand public mal classé est un désagrément mineur. Un produit chimique industriel ou un interrupteur électrique mal classé est un risque de conformité grave.
Enfin, oublie le mythe du « on configure et on n'y touche plus ». Les taxonomies e-commerce sont dynamiques. À mesure que de nouvelles catégories de produits apparaissent (comme une catégorie de gadget tech inédite qui n'existait pas il y a douze mois), les modèles ont besoin d'être réentraînés et encadrés.
Arrête de traiter la catégorisation des produits comme une tâche IT de back-office. C'est la base de la recherche à facettes, du balisage SEO et de la génération de chiffre d'affaires. Automatiser tes processus de mapping transforme une gestion de données complexe en une opération simple et évolutive, et fait de ton catalogue non plus une charge opérationnelle mais un véritable avantage concurrentiel.