Getrennte Systeme und Datensilos kosten E-Commerce-Unternehmen echten Umsatz. Ein großer Teil dieser Verluste entsteht ganz am Anfang des Katalog-Lebenszyklus: beim Versuch, unordentliche, unstrukturierte Lieferantendaten in einen starren Kategoriebaum zu pressen. Nimm den britischen Lebensmittelhandel im Jahr 2026: Ein großer Teil der Umsätze stammt aus Eigenmarken, denen oft universelle Produkt-IDs wie GTINs oder EANs fehlen. Auf einen Barcode-Abgleich kannst du dich nicht verlassen. Du musst die Beschreibung lesen, den Kontext verstehen und das Produkt korrekt zuordnen.
Früher wurde das mit riesigen, fehleranfälligen Tabellen erledigt. Moderne E-Commerce-Teams automatisieren es.
Der globale PIM-Markt wächst weiter, vor allem getrieben vom Wechsel von manueller Dateneingabe zu automatisiertem, semantischem Verständnis. Händler mit sauberen, AI-gestützten Taxonomien holen mehr aus der Facettensuche heraus, ganz einfach, weil ihre Filter tatsächlich funktionieren.
So hörst du auf, Regeln von Hand zu schreiben, und automatisierst stattdessen deine Produktklassifizierung.
Das Ende der Zuordnungstabelle
Jahrelang bedeutete das Mapping von Lieferantendaten auf deine interne Produkttaxonomie, endlose IF/THEN-Anweisungen zu schreiben. Wenn der Titel „shirt“ enthält, ordne „Apparel“ zu. Wenn die Beschreibung „length 50 cm“ enthält, extrahiere „50“ und ordne es dem Attribut „Length“ zu.
Dieser regelbasierte Ansatz bricht zusammen, sobald ein Lieferant „iPhone 12 64GB Blue“ schickt und ein anderer „Apple iPhone 12 - 64 GB, Color: Blue“. Legacy-Systeme behandeln das als zwei verschiedene SKUs. Dein Bestand zersplittert. Doppelte Listings tauchen auf.
Die Branche ist zu Large Language Models (LLMs) und Natural Language Processing (NLP) übergegangen. Diese Modelle verstehen semantischen Kontext. Sie wissen, dass „Athleisure“ zu „Yogahosen“ oder „Activewear“ gehört, ohne dass ein Mensch diese Verbindung ausdrücklich anlegen muss. Damit entfallen manuelle Product Data Transformation Rules, die ständig gepflegt werden müssen.
Schritt für Schritt: Taxonomie-Mapping automatisieren
Die Automatisierung deiner Klassifizierung erfordert eine bestimmte Reihenfolge. Wer direkt zum AI-Modell springt, bekommt meist selbstbewusste Halluzinationen.
Die vier Schritte für automatisiertes Taxonomie-Mapping
Schritt 1: Eingangsdaten vorverarbeiten und standardisieren
Data Scientists im E-Commerce werden dir bestätigen: Saubere Eingangsdaten steigern die Trefferquote weit mehr als ein Upgrade auf das neueste AI-Modell.
Händler erhalten Produktdaten in völlig uneinheitlichen Formaten. Von einem Anbieter kommt eine chaotische Excel-Tabelle, vom nächsten ein schlecht formatierter XML-Feed. Bevor irgendein Mapping passiert, lass ein Vorverarbeitungsskript laufen, das HTML-Tags entfernt, Maßeinheiten vereinheitlicht („inches“ wird zu „in“) und die Groß- und Kleinschreibung normalisiert. Saubere Daten geben der Klassifizierungs-Engine eine klare Ausgangsbasis.
Schritt 2: Multimodale Kontextextraktion einsetzen
Sich nur auf Text zu verlassen, ist ein Fehler. Die fortschrittlichsten Systeme nutzen multimodale AI, um Produkttitel, Beschreibungen, Lieferantenbilder und Kundenbewertungen gleichzeitig zu analysieren.
Wenn in einer Lieferantenbeschreibung nur „Classic Blue V-Neck“ steht, ordnet das Textmodell das Produkt vielleicht den Herren-T-Shirts zu. Durch die Analyse des mitgelieferten Lieferantenbilds erkennt ein multimodales Modell einen Damen-Kaschmirpullover. Die Kombination aus Bildanalyse und Textverarbeitung fängt Fehlzuordnungen ab, die reiner Text übersieht.
Schritt 3: Semantisches Attribut-Mapping ausführen
Sobald der Kontext steht, ordnet das System die extrahierten Daten deiner spezifischen Hierarchie zu. Tools wie getName.ai treten in dieser Phase als „Mapping-Killer“ auf.
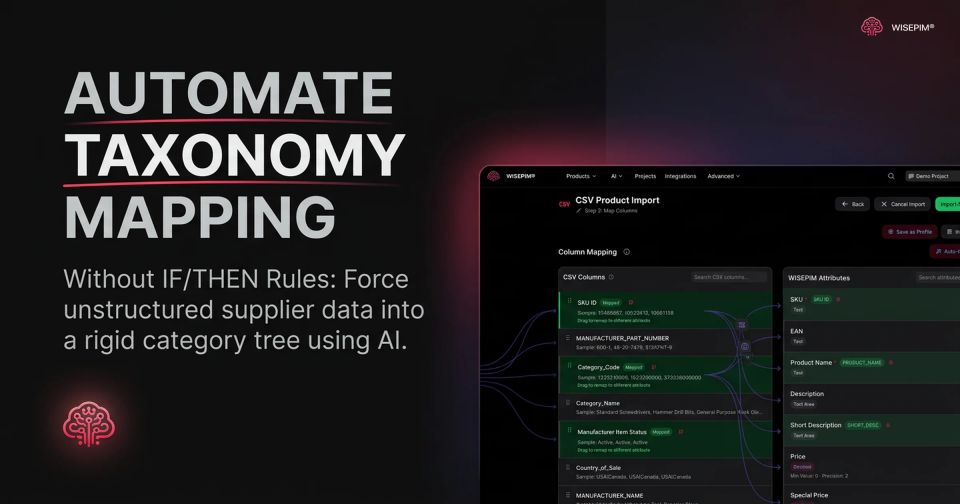
Statt sich auf starre Tabellen zu verlassen, liest ein Semantic Pim eine Formulierung wie „wasserdicht bis 50 m“ und legt sie automatisch als numerisches Attribut mit Einheit im richtigen Datenbankfeld ab. Das ist besonders wichtig, wenn unstrukturierte Lieferantendaten direkt auf globale Standards wie GS1, ECLASS oder Etim für elektrotechnische Waren gemappt werden. Die AI versteht die Anforderungen des Ziels und formatiert die Daten passend.
Schritt 4: Den Human-in-the-Loop-Workflow einführen
AI ist ein Elektrowerkzeug, keine Magie. Sie glänzt bei ersten Entwürfen in großer Menge und bei repetitiver Formatierung. Für komplexe Sonderfälle fehlt ihr das Fachurteil.
Das gängige operative Modell ist Human-in-the-Loop (HITL). Du konfigurierst das System so, dass es 95 % des Katalog-Mappings auf Basis hoher Konfidenzwerte automatisiert. Die restlichen 5 % mehrdeutiger Produkte gehen automatisch zur Prüfung an menschliche Merchandiser. Native Dienste wie SAP AI Data Attribute Recommendation hängen an jede Vorhersage einen Konfidenzwert und sagen deinem Team genau, wann es der Maschine vertrauen kann und wann es das Ergebnis prüfen sollte.
Der ROI von automatisiertem Mapping
Theoretische Modelle zählen nur, wenn sie greifbare Geschäftsergebnisse liefern.
Nimm LemonMind, eine Agentur, die vor Kurzem eine riesige PIM-Migration umgesetzt hat. Ihr Kunde musste 500.000 Produkte aus einer veralteten Kategoriestruktur in eine neu überarbeitete Taxonomie überführen. Eine halbe Million SKUs von Hand neu zu klassifizieren, dauert Monate. Mit AI automatisierten sie das Mapping mit einer Effizienzquote von 95 %. Übrig blieben nur 25.000 Sonderfälle für die manuelle Prüfung, was Tausende Stunden Handarbeit sparte.
Amantra, ein globaler Händler mit über 1 Million SKUs, hatte einen ähnlichen Engpass durch unvollständige Lieferanten-Uploads. Das Unternehmen führte eine LLM-basierte Klassifizierungs-Engine ein, die unstrukturierten Text auswertete, fehlende Metadaten ergänzte und Kategorien kontextbezogen zuordnete. Das System kam mit dem mehrsprachigen Katalog zurecht und passte sich saisonalen Taxonomie-Änderungen an, ohne dass eine einzige Regel manuell aktualisiert werden musste.
Wenn ein Kunde auf deiner Website nach „Wasserdicht“ filtert und einer Jacke dieses Attribut fehlt, existiert sie praktisch nicht. Das ist reiner Umsatzverlust. AI-gestütztes Attribut-Mapping schließt diese Lücke und spart einen großen Teil der manuellen Kategoriezuordnung.
Der Realitätscheck: Grenzen und Risiken
Automatisierung bringt Risiken mit sich. Du musst sie kennen, bevor du solche Systeme in großem Maßstab einsetzt.
Skeptiker verweisen zu Recht auf das Prinzip „Garbage in, garbage out“. AI-Modelle hängen stark von ihren Trainingsdaten ab. Sind die Eingangsdaten eines Lieferanten grundlegend fehlerhaft, klassifiziert die AI das Produkt selbstbewusst falsch.
Außerdem fehlt generalistischen LLMs oft das B2B-Fachwissen. In Spezialbranchen wie Elektrokomponenten, Baustoffen oder Medizinprodukten missversteht AI häufig Fachjargon. Ein falsch klassifiziertes T-Shirt ist ein kleines Ärgernis. Eine falsch klassifizierte Industriechemikalie oder ein falsch klassifizierter Elektroschalter ist ein ernstes Compliance-Risiko.
Und verabschiede dich vom Mythos „einrichten und vergessen“. E-Commerce-Taxonomien sind dynamisch. Wenn neue Produktkategorien entstehen (etwa eine neuartige Tech-Gadget-Kategorie, die es vor zwölf Monaten noch nicht gab), brauchen die Modelle neues Training und Governance.
Hör auf, Produktkategorisierung als Backend-IT-Aufgabe zu behandeln. Sie ist das Fundament für Facettensuche, SEO-Markup und Umsatz. Wenn du dein Mapping automatisierst, wird aus komplexem Datenmanagement ein einfacher, skalierbarer Ablauf, und dein Katalog wird von einer operativen Last zu einem echten Wettbewerbsvorteil.