Dateneingabe automatisieren heißt: Software überträgt Informationen in ein System, damit niemand sie abtippen muss. Für einen Produktkatalog läuft das auf fünf verbundene Schritte hinaus: Du importierst die Lieferantendatei in dem Format, in dem sie ankommt, ordnest ihre Spalten einmal deinen Feldern zu und nutzt diese Zuordnung wieder, lässt KI Attribute aus Beschreibungen, Fotos und Webseiten auslesen, prüfst jeden Datensatz vor dem Livegang gegen Validierungsregeln und gibst nur die unsicheren Werte an einen Menschen weiter.
Dieser Leitfaden behandelt diese Produktdaten-Variante. Es geht nicht um Robotic Process Automation für die Dateneingabe, bei der Bots sich so durch Masken klicken wie ein Mensch. RPA kopiert Tastenanschläge. Eine Produktdaten-Pipeline arbeitet mit den Daten selbst, versteht also auch, was ein Wert bedeutet, und kann ihn ablehnen, wenn er falsch ist.
Was das Erfassen eines einzigen neuen Produkts wirklich bedeutet
Nimm einen einzelnen Akkubohrschrauber von einem Werkzeuggroßhändler. Bevor er sich verkauft, muss jemand SKU und EAN eintragen, einen Titel und eine Beschreibung schreiben, technische Attribute wie Spannung, Akkukapazität, Bohrfutterweite und Drehmoment ausfüllen, eine Kategorie wählen, Bilder anhängen, Preis und Gewicht festlegen und die Texte für jeden Markt übersetzen. Das sind 20 oder mehr Felder, und die meisten Informationen stehen längst in der Datei des Lieferanten, in einem PDF-Datenblatt oder auf der Produktseite des Herstellers.
Leer bleiben die strukturierten Felder. Als WISEPIM 50 Produktkataloge im Moment des Imports analysiert hat, also vor jeder Anreicherung, war das Attribut im Median der 32 Kataloge, die Attribute nutzen, bei nur 1,9 % der Produkte gefüllt, und 81 % der Attribute waren bei weniger als einem Viertel der Produkte gefüllt. Titel und Preise werden ausgefüllt, weil ohne sie nichts verkauft wird. Spannung, Material und Kompatibilität werden übersprungen, und genau von diesen Feldern hängen Filter, Feeds und Vergleichstabellen ab.
Fünf Stufen von der Lieferantendatei zum veröffentlichten Produkt
Eine automatisierte Pipeline für die Produktdaten-Erfassung
Jede Stufe nimmt dir eine Art Tipparbeit ab. Die Zuordnung ersetzt Kopieren und Einfügen zwischen Tabellen. Die Normalisierung ersetzt das Umformatieren von Zahlen und Einheiten. Die Extraktion ersetzt das Lesen einer Beschreibung und das manuelle Ausfüllen von Attributfeldern. Die Validierung ersetzt das abschließende Korrekturlesen, und die Prüfung hält einen Menschen bei den Entscheidungen, die Urteilsvermögen brauchen.
Stufe 1: Lieferantendaten in dem Format annehmen, in dem sie kommen
Lieferanten schicken CSV-Exporte, Excel-Arbeitsmappen mit mehreren Tabellenblättern, XML-Feeds, Links zu einer Feed-URL oder nur einen Webshop, aus dem du übernehmen darfst. Eine automatisierte Annahme verarbeitet jedes dieser Formate, ohne dass der Lieferant sein System ändern muss. Das einzige Format, bei dem du gegenhalten solltest, ist die PDF-Preisliste: Sie ist zum Lesen gemacht, nicht zum Importieren. Bitte also um dieselben Daten als CSV oder Excel und behalte das PDF-Datenblatt als Quelle für die Attribut-Extraktion.
Excel richtet den meisten stillen Schaden an. Microsoft weist darauf hin, dass Excel führende Nullen entfernt und große Zahlen in wissenschaftliche Schreibweise umwandelt. Eine Barcode-Spalte im Format Standard kann also ihre führende Null verlieren oder zu 9.50600E+12 werden, bevor dein Import überhaupt beginnt. Der Beitrag über Dirty Data erklärt, wie du Barcodes reparierst, die schon durch eine Tabellenkalkulation gegangen sind. Bei einer automatisierten Annahme hältst du sie lieber direkt am Eingang auf: Bitte Lieferanten, Barcode-Spalten als Text zu formatieren, und nutze einen Import, der eine beschädigte Zahl ablehnt, statt sie zu speichern. Der CSV-Import von WISEPIM markiert eine EAN in wissenschaftlicher Schreibweise und fordert dich auf, die Spalte als Text zu formatieren und die Datei erneut zu exportieren.
Die Beispiellieferung in diesem Leitfaden
Die folgenden Beispiele begleiten eine Zeile aus der Excel-Datei eines europäischen Werkzeuglieferanten: Art. no. KB-4471, EAN code 9506000134352 (die Demonstrationsnummer von GS1), Description short "Cordless drill 18V 2x2.0Ah case", Price excl. VAT "89,95", Weight "1,6 kg", Colour "zw" und eine lange Beschreibung von etwa 80 Wörtern, in deren Fließtext die Spezifikationen versteckt sind.
Stufe 2: Lieferantenspalten einmal zuordnen und die Zuordnung wiederverwenden
Die Zuordnung (Mapping) sagt dem Import, welche Lieferantenspalte welches deiner Felder füllt und welche Umwandlung unterwegs läuft. Einmal pro Lieferant erledigt und gespeichert, wird jede spätere Lieferung zu einem erneuten Durchlauf. Die Tabelle zeigt, was das für die Beispielzeile bedeutet.
Zuordnung der Zeile KB-4471 zu Katalogfeldern
| Art. no. | KB-4471 | SKU | Keine, dient als Abgleichsschlüssel |
|---|---|---|---|
| EAN code | 9506000134352 | EAN / GTIN | Als Text behalten, Prüfziffertest |
| Description short | Cordless drill 18V 2x2.0Ah case | Lieferantentitel (roh) | Als Referenz behalten, später neu geschrieben |
| Price excl. VAT | 89,95 | Einkaufspreis | Dezimalkomma zu Dezimalpunkt |
| Weight | 1,6 kg | Gewicht + Einheit | Aufteilen in 1.6 und kg |
| Colour | zw | Farbe | Wertezuordnung: zw zu Schwarz |
| Long description | 80 Wörter Fließtext | Beschreibung (Quelle) | Eingabe für die KI-Extraktion |
Zwei Entscheidungen bei der Zuordnung zählen mehr als die Spaltenpaare. Die erste ist der Abgleichsschlüssel: Wenn ein Lieferant Artikelnummern über mehrere Sortimente hinweg wiederverwendet, gleiche zuerst über die EAN ab, damit ein Update beim richtigen Produkt landet. Die zweite ist, was ein Update überschreiben darf. Sobald dein Team Titel und Beschreibungen neu geschrieben hat, sollte die nächste Lieferantendatei Preis, Bestand und Gewicht aktualisieren und die angereicherten Texte in Ruhe lassen.
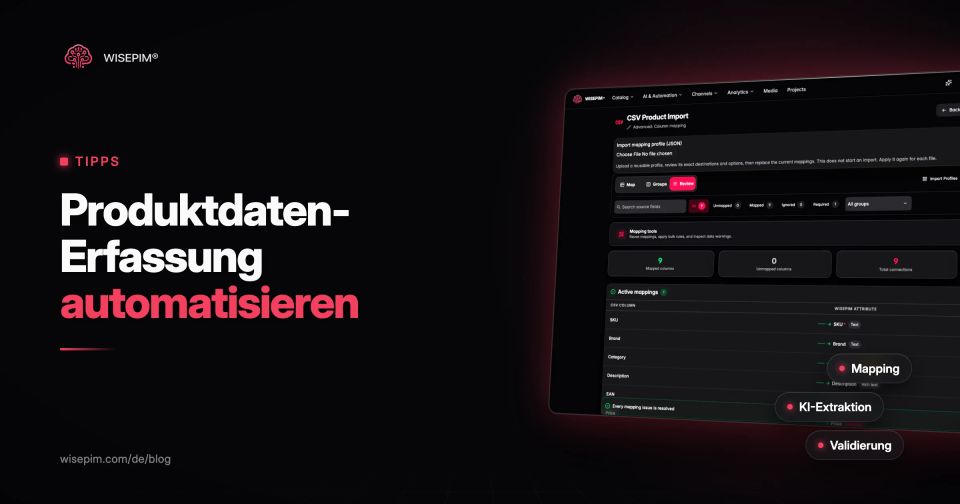
Beim Produktimport von WISEPIM wird eine hochgeladene CSV- oder Excel-Datei automatisch deinen Feldern zugeordnet, fehlende Attribute lassen sich direkt beim Import anlegen, und die Zuordnung wird als Importprofil für die nächste Lieferung desselben Lieferanten gespeichert. Du kannst außerdem wählen, ob vor der SKU über die EAN abgeglichen wird oder ob nur bestehende Produkte aktualisiert und neue Zeilen übersprungen werden.
Stufe 3: KI liest Attribute aus Texten, Fotos und Webseiten aus
Für diesen Schritt musste früher jemand jede Beschreibung lesen. Ein Sprachmodell liest den Fließtext des Lieferanten und liefert strukturierte Werte zurück. Aus der langen Beschreibung von KB-4471 würde ein Extraktionslauf diese Felder füllen:
- Spannung: 18 V
- Akkukapazität: 2,0 Ah, Akkus im Lieferumfang: 2
- Bohrfutterweite: 13 mm, Schnellspannbohrfutter
- Maximales Drehmoment: 45 Nm
- Gänge: 2
- Transportkoffer im Lieferumfang: Ja
Drei Regeln halten die Extraktion vertrauenswürdig. Bei Dropdown-Attributen darf das Modell nur aus den Optionen wählen, die du schon verwendest, damit "Black", "black" und "zwart" nicht zu drei Filterwerten werden. Wenn der Quelltext einen Wert nicht nennt, bleibt das Feld leer: Ein geratener Drehmomentwert ist schlimmer als ein leeres Feld. Und die Extraktion füllt standardmäßig nur Lücken, sodass Werte, die ein Mensch schon geprüft hat, nicht überschrieben werden.
Text ist nicht die einzige Quelle. Wenn die Lieferantenbeschreibung dünn ist, kann eine Websuche nach EAN, MPN oder Marke und Modell die Spezifikationen von öffentlichen Seiten zusammentragen. WISEPIM Web Research arbeitet so und schreibt nur die Felder zurück, die du einschaltest. Das Überschreiben bleibt aus, bis du es aktivierst. Für Kataloge, die nur als Webshop existieren, kann WISEPIM Produkte aus einer Kategorieseite, einer Sitemap oder einer Liste von URLs importieren. Der Job Fill the gaps (Lücken füllen) in Catalog Jobs geht noch einen Schritt weiter: Er liest das Produktfoto, um leere Attribute zu füllen, und jede Antwort unter der von dir festgelegten Konfidenzschwelle wartet in der Prüfwarteschlange, statt übernommen zu werden.
Auch Kategorien gehören in diese Stufe. 500 neue Produkte von Hand in eine Taxonomie einzuordnen dauert lange, und zwei Kollegen ordnen sie selten gleich ein. Die KI-Kategorisierung von WISEPIM erreicht eine Genauigkeit von 95 %+. Für Attribute und Beschreibungen gibt es keine vergleichbare Zahl, plane also stattdessen eine Stichprobenprüfung ein.
Stufe 4: Validierungsregeln, die unvollständige Produkte zurückhalten
Automatisierte Eingabe ohne Validierung produziert nur schneller Fehler. Regeln laufen nach der Extraktion auf jedem Datensatz und entscheiden, ob er veröffentlicht werden darf, eine Warnung bekommt oder gestoppt werden muss. Google Merchant Center zum Beispiel verlangt für jedes Produkt eine ID, einen Titel, eine Beschreibung, einen Link, einen Bildlink, die Verfügbarkeit und einen Preis und begrenzt Titel auf 150 Zeichen. Das sind naheliegende blockierende Regeln für einen Shopping-Feed. Der Leitfaden zur Datenvalidierung erklärt die Regeltypen genauer. Ein Startset für Lieferantenimporte:
Validierungsregeln, die vor der Veröffentlichung eines Lieferantenimports laufen
Die Prüfzifferregel kostet wenig und fängt mehr ab, als man erwartet. GS1 veröffentlicht die Berechnung der Prüfziffer: Gewichte die Ziffern von rechts abwechselnd mit 3 und 1, addiere sie und nimm die Differenz zum nächsten Vielfachen von zehn. Ein Barcode, der diesen Test nicht besteht, wurde falsch eingetippt oder abgeschnitten, egal was der Lieferant sagt.
In WISEPIM sind diese Prüfungen Regeln in Quality Guard. Jede Regel zielt auf ein Feld und eine Produktmenge und blockiert, warnt oder überspringt. Produkte, die an einer blockierenden Regel scheitern, erreichen deine Kanäle nie. Regelpakete pro Kanal und ein KI-Regelgenerator ersparen dir, die üblichen Regeln selbst zu schreiben.
Stufe 5: entscheiden, welche Werte ein Mensch noch prüft
Volle Automatisierung ist bei Produktdaten das falsche Ziel. Ziel ist, dass Menschen nur die Datensätze sehen, bei denen ihr Urteil etwas beiträgt. Prüfe standardmäßig diese:
- Neue Optionswerte, die eine Extraktion einem Dropdown-Attribut hinzufügen will, bevor sie zu Filterwerten werden.
- Sicherheits-, Rechts- und Zertifizierungsangaben wie IP-Schutzarten, CE-Kennzeichnung oder Altershinweise, die vom Lieferanten kommen müssen und nicht aus einer Schlussfolgerung.
- Zahlen mit Einheiten beim ersten Durchlauf eines neuen Lieferanten, wo ein falsch gelesenes 2,0 Ah oder 13 mm sich über ein ganzes Sortiment wiederholen kann.
- Eine Stichprobe aus der ersten Lieferung jedes neuen Lieferanten, zum Beispiel 20 Produkte, bevor du dieselbe Zuordnung und dieselben Prompts unbeaufsichtigt laufen lässt.
Nach ein paar sauberen Lieferungen desselben Lieferanten verkleinerst du die Stichprobe. Lass die Regeln dauerhaft laufen: Sie sind der Grund, warum du nicht mehr jeden Datensatz lesen musst.
Die Stufen verketten, damit die nächste Lieferung keinen Klick braucht
Sobald jede Stufe für sich funktioniert, verbindest du sie. Eine typische Kette: Ein Zeitplan holt jede Nacht den Lieferanten-Feed von seiner URL, die gespeicherte Zuordnung importiert ihn, ein Auslöser nach dem Import wählt die neu importierten Produkte aus, Bereinigung und Extraktion laufen darauf, und die Validierung entscheidet, was veröffentlicht wird. Die Automatisierungen von WISEPIM unterstützen das mit Auslösern nach Zeitplan und nach dem Import sowie einem Knoten für den Import per URL für CSV-, Excel- und XML-Feeds.
Um zu beurteilen, ob sich die Kette lohnt, vergleiche die Zeit pro Lieferung vorher und nachher. Ein Beispiel mit angenommenen Zahlen: Wenn das manuelle Erfassen eines Produkts 8 Minuten dauert und ein Lieferant 300 neue Produkte im Monat schickt, sind das 40 Stunden Eingabe. Wenn die automatisierte Kette 15 % der Produkte zur Prüfung übrig lässt, mit je 2 Minuten, braucht dieselbe Lieferung 1,5 Stunden Aufmerksamkeit, plus den einmaligen Aufwand für Zuordnung und Regeln. Miss vor dem Start deine eigenen Minuten pro Produkt, sonst hast du nichts zum Vergleichen.
Sechs Arten, wie automatisierte Produkterfassung schiefgeht
- Der Lieferant benennt eine Spalte um. Aus "Price excl. VAT" wird "Net price", und die gespeicherte Zuordnung überspringt sie stillschweigend. Lass den Import nicht zugeordnete Spalten melden und bei einer fehlenden Pflichtspalte stoppen.
- Eine Aktualisierung überschreibt angereicherte Texte. Die zweite Lieferung ersetzt deine neu geschriebenen Beschreibungen durch Lieferantentexte. Beschränke Updates auf kaufmännische Felder.
- Freitext-Attribute sammeln Schreibweisen. Wenn KI in ein Textfeld statt in ein Dropdown schreiben darf, entstehen "Edelstahl", "edelstahl" und "RVS" für ein einziges Material.
- Die Veröffentlichung läuft, bevor es Regeln gibt. Schalte automatisches Veröffentlichen erst ein, wenn die blockierenden Regeln stehen.
- Abgleich über eine wiederverwendete SKU. Zwei Produkte aus verschiedenen Sortimenten verschmelzen zu einem Datensatz. Gleiche über die EAN ab, wo die Artikelnummern des Lieferanten nicht stabil sind.
- Niemand ist für die Ausnahmen zuständig. Eine Prüfwarteschlange, die niemand leert, wird zum zweiten Rückstau. Benenne pro Lieferant eine verantwortliche Person.
Sauberere Dateien beginnen mit einem Datenvertrag pro Lieferant: die Spalten, Einheiten, erlaubten Werte und das Barcode-Format, die du erwartest, verschickt vor der ersten Lieferung. Der Beitrag über Dirty Data listet auf, was hineingehört. WISEPIM deckt die Stufen aus diesem Beitrag an einem Ort ab: Import mit gespeicherten Zuordnungen, KI-Extraktion und Recherche, Quality-Guard-Regeln und Automatisierungen. Der kostenlose Plan (100 Produkte) reicht, um den Import und die KI-Extraktion mit einer Lieferantendatei zu testen. Web Research, Automatisierungen und Quality Guard gibt es in den kostenpflichtigen Plänen.