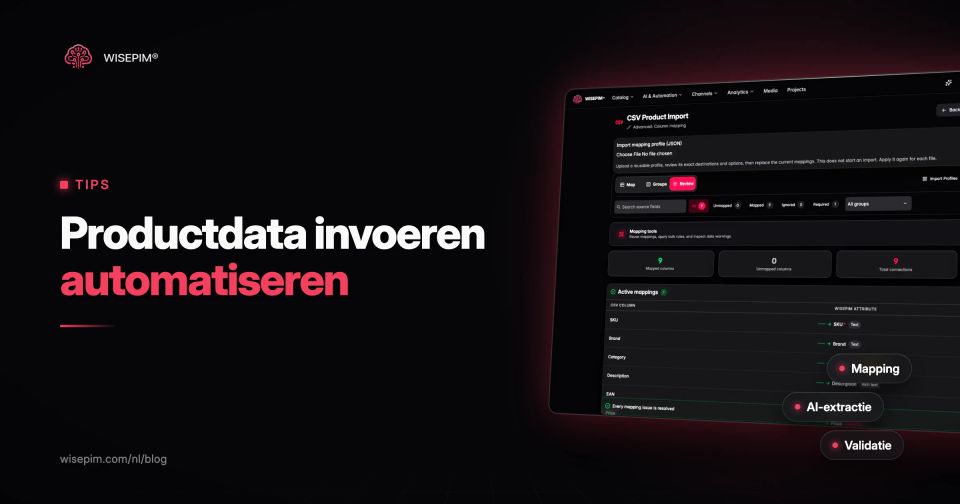
Data entry automatiseren betekent dat software gegevens in een systeem zet zonder dat iemand ze overtypt. Voor een productcatalogus komt dat neer op vijf gekoppelde stappen: het leveranciersbestand importeren in het formaat waarin het binnenkomt, de kolommen één keer mappen op je eigen velden en die mapping hergebruiken, AI attributen laten halen uit omschrijvingen, foto's en webpagina's, elk product tegen validatieregels houden voordat het live gaat, en alleen de twijfelgevallen naar een collega sturen.
Dit artikel gaat over die productdata-variant. Het gaat niet over RPA voor data entry, waarbij bots door schermen klikken zoals een mens dat zou doen. RPA kopieert toetsaanslagen. Een productdatapijplijn werkt met de data zelf, dus hij begrijpt ook wat een waarde betekent en houdt hem tegen als hij niet klopt.
Wat er komt kijken bij het invoeren van één nieuw product
Neem één accuboormachine van een gereedschapsgroothandel. Voordat die verkocht kan worden, moet iemand de SKU en EAN invoeren, een titel en omschrijving schrijven, technische attributen vullen zoals voltage, accucapaciteit, boorhouder en koppel, een categorie kiezen, afbeeldingen koppelen, prijs en gewicht instellen en de tekst vertalen voor elke markt. Dat zijn al gauw 20 velden of meer, en het meeste staat al in het bestand van de leverancier, in een PDF-datasheet of op de productpagina van de fabrikant.
Juist de gestructureerde velden blijven leeg. Toen WISEPIM 50 productcatalogi analyseerde op het moment van importeren, nog vóór enige verrijking, was in de 32 catalogi die attributen gebruiken het mediane attribuut bij maar 1,9% van de producten gevuld, en was 81% van de attributen bij minder dan een kwart van de producten ingevuld. Titels en prijzen worden wel gevuld, want zonder die velden verkoopt niets; voltage, materiaal en compatibiliteit schieten erbij in, en juist daar draaien filters, feeds en vergelijkingstabellen op.
Vijf stappen van leveranciersbestand naar gepubliceerd product
Een geautomatiseerde pijplijn voor productdata-invoer
Elke stap haalt één soort typewerk weg. Mapping vervangt kopiëren en plakken tussen spreadsheets. Normaliseren vervangt het omzetten van getallen en eenheden. Extractie vervangt het lezen van een omschrijving en het met de hand vullen van attributen. Validatie vervangt de laatste controleronde, en review houdt een mens bij de beslissingen waar oordeel voor nodig is.
Stap 1: neem leveranciersdata aan zoals die binnenkomt
Leveranciers sturen CSV-exports, Excel-bestanden met meerdere tabbladen, XML-feeds, een link naar een feed-URL of alleen een webshop waaruit je mag overnemen. Een geautomatiseerde intake verwerkt elk van deze formaten zonder dat de leverancier zijn systeem hoeft aan te passen. Het enige formaat waar je op terug moet duwen, is de PDF-prijslijst: die is gemaakt om te lezen, niet om te importeren. Vraag dezelfde data als CSV of Excel en gebruik de PDF-datasheet als bron voor attribuutextractie.
Excel richt de meeste stille schade aan. Microsoft schrijft dat Excel voorloopnullen verwijdert en grote getallen omzet naar wetenschappelijke notatie, dus een barcodekolom in de opmaak Standaard kan zijn voorloopnul kwijtraken of veranderen in 9,50600E+12 voordat je import begint. Het artikel over dirty data laat zien hoe je barcodes herstelt die al door een spreadsheet zijn gegaan. Bij geautomatiseerde invoer houd je ze liever aan de deur tegen: vraag leveranciers om barcodekolommen als tekst op te maken en gebruik een importer die een kapot getal weigert in plaats van het op te slaan. De CSV-import van WISEPIM markeert een EAN in wetenschappelijke notatie en vraagt je de kolom als tekst op te maken en het bestand opnieuw te exporteren.
De voorbeeldlevering in dit artikel
De voorbeelden hieronder volgen één regel uit het Excel-bestand van een Europese gereedschapsleverancier: Art. nr. KB-4471, EAN-code 9506000134352 (het demonstratienummer van GS1), Korte omschrijving "Accuboormachine 18V 2x2.0Ah koffer", Prijs excl. btw "89,95", Gewicht "1,6 kg", Kleur "zw", en een lange omschrijving van zo'n 80 woorden met de specificaties verstopt in lopende tekst.
Stap 2: map leverancierskolommen één keer en hergebruik de mapping
Een mapping vertelt de import welke leverancierskolom welk veld van jou vult, en welke omzetting er onderweg op draait. Doe je dat één keer per leverancier en sla je het op, dan wordt elke volgende levering een herhaling. De tabel laat zien wat dat betekent voor de voorbeeldregel.
De regel KB-4471 gemapt op catalogusvelden
| Art. nr. | KB-4471 | SKU | Geen, dient als matchsleutel |
|---|---|---|---|
| EAN-code | 9506000134352 | EAN / GTIN | Als tekst houden, controlecijfer testen |
| Korte omschrijving | Accuboormachine 18V 2x2.0Ah koffer | Leverancierstitel (ruw) | Bewaard als referentie, later herschreven |
| Prijs excl. btw | 89,95 | Inkoopprijs | Decimale komma naar decimale punt |
| Gewicht | 1,6 kg | Gewicht + eenheid | Splitsen in 1.6 en kg |
| Kleur | zw | Kleur | Waardetabel: zw wordt Zwart |
| Lange omschrijving | 80 woorden lopende tekst | Omschrijving (bron) | Input voor AI-extractie |
Twee keuzes in de mapping wegen zwaarder dan de kolomparen. De eerste is de matchsleutel: hergebruikt een leverancier artikelnummers tussen series, match dan eerst op EAN, zodat een update op het juiste product terechtkomt. De tweede is wat een update mag overschrijven. Zodra je team titels en omschrijvingen heeft herschreven, moet het volgende leveranciersbestand prijs, voorraad en gewicht bijwerken en de verrijkte tekst met rust laten.
Bij producten importeren in WISEPIM wordt een CSV- of Excel-bestand automatisch gemapt op je velden, kun je ontbrekende attributen tijdens de import aanmaken en wordt de mapping bewaard als importprofiel voor de volgende levering van dezelfde leverancier. Je kunt ook kiezen om eerst op EAN en dan op SKU te matchen, of alleen bestaande producten bij te werken en nieuwe regels over te slaan.
Stap 3: laat AI attributen halen uit tekst, foto's en webpagina's
Dit is de stap waarvoor vroeger iemand elke omschrijving moest lezen. Een taalmodel leest de lopende tekst van de leverancier en geeft gestructureerde waarden terug. Uit de lange omschrijving van KB-4471 vult een extractie:
- Voltage: 18 V
- Accucapaciteit: 2,0 Ah, meegeleverde accu's: 2
- Boorhouder: 13 mm, snelspan
- Maximaal koppel: 45 Nm
- Versnellingen: 2
- Opbergkoffer: Ja
Drie regels houden extractie betrouwbaar. Bij keuzelijst-attributen mag het model alleen kiezen uit opties die je al gebruikt, zodat "Zwart", "zwart" en "black" geen drie filterwaarden worden. Staat een waarde niet in de brontekst, dan blijft het veld leeg; een gegokt koppel is erger dan een leeg veld. En extractie vult standaard alleen lege velden, dus waarden die een collega al heeft gecontroleerd worden niet overschreven.
Tekst is niet de enige bron. Is de leveranciersomschrijving mager, dan kan een webopzoeking op EAN, MPN of merk en model de specificaties van openbare pagina's halen. Webonderzoek in WISEPIM werkt zo en schrijft alleen de velden terug die je aanzet, met overschrijven uit totdat je het inschakelt. Bestaat een catalogus alleen als webshop, dan importeert WISEPIM producten vanaf een categoriepagina, een sitemap of een lijst met URL's. De job Vul de gaten in Catalog Jobs gaat nog een stap verder: die leest de productfoto om lege attributen te vullen, en elk antwoord onder de zekerheidsdrempel die je instelt, wacht op de controlelijst in plaats van meteen te worden toegepast.
Categorieën horen ook in deze stap. 500 nieuwe producten met de hand in een taxonomie plaatsen is traag, en twee collega's doen het zelden op dezelfde manier. De AI-categorisering van WISEPIM is voor 95%+ accuraat; voor attributen en omschrijvingen bestaat geen vergelijkbaar cijfer, dus plan daar een steekproef in.
Stap 4: validatieregels die onvolledige producten tegenhouden
Geautomatiseerde invoer zonder validatie maakt alleen sneller fouten. Regels draaien na de extractie op elk product en beslissen of het mag publiceren, een waarschuwing krijgt of moet stoppen. Google Merchant Center vereist bijvoorbeeld voor elk product een id, titel, omschrijving, link, afbeeldingslink, beschikbaarheid en prijs en staat titels toe van maximaal 150 tekens, dus dat zijn logische blokkerende regels voor een Shopping-feed. De gids over datavalidatie legt de soorten regels verder uit. Een startset voor leveranciersimports:
Validatieregels voordat een leveranciersimport live gaat
De controlecijferregel is goedkoop en vangt meer dan je zou denken. GS1 publiceert de berekening van het controlecijfer: weeg de cijfers van rechts afwisselend met 3 en 1, tel ze op en neem het verschil tot het volgende tiental. Een barcode die daarvoor zakt, is verkeerd overgetypt of afgekapt, wat de leverancier ook zegt.
In WISEPIM zijn deze controles regels in Quality Guard. Elke regel richt zich op een veld en een groep producten en blokkeert, waarschuwt of slaat over; producten die op een blokkerende regel zakken, bereiken je kanalen nooit. Rule packs per kanaal en een AI-regelgenerator besparen je het zelf schrijven van de gangbare regels.
Stap 5: bepaal welke waarden een collega nog controleert
Volledige automatisering is voor productdata het verkeerde doel. Het idee is dat mensen alleen de producten zien waar hun oordeel iets toevoegt. Controleer standaard:
- Nieuwe optiewaarden die een extractie aan een keuzelijst wil toevoegen, voordat ze filterwaarden worden.
- Veiligheids-, juridische en certificeringsclaims, zoals IP-klassen, CE-markering of leeftijdswaarschuwingen, die van de leverancier moeten komen en niet afgeleid mogen worden.
- Getallen met eenheden bij de eerste run van een nieuwe leverancier, waar een verkeerd gelezen 2,0 Ah of 13 mm zich over een hele serie kan herhalen.
- Een steekproef uit de eerste levering van elke nieuwe leverancier, bijvoorbeeld 20 producten, voordat dezelfde mapping en prompts zonder toezicht draaien.
Na een paar foutloze leveringen van dezelfde leverancier maak je de steekproef kleiner. Laat de regels altijd aan staan; die zorgen ervoor dat je niet meer elk product hoeft te lezen.
De stappen koppelen zodat de volgende levering geen klikken kost
Werkt elke stap op zichzelf, koppel ze dan aan elkaar. Een gangbare keten: een schema haalt elke nacht de leveranciersfeed op van zijn URL, de opgeslagen mapping importeert hem, een trigger na de import selecteert de nieuw geïmporteerde producten, opschonen en extractie draaien erop, en validatie beslist wat er publiceert. Automatiseringen in WISEPIM ondersteunen dit met schema- en na-import-triggers en een URL-importnode voor CSV-, Excel- en XML-feeds.
Of de keten zich terugbetaalt, zie je als je de tijd per levering voor en na vergelijkt. Een voorbeeld met aangenomen getallen: kost het met de hand invoeren van één product 8 minuten en stuurt een leverancier 300 nieuwe producten per maand, dan is dat 40 uur invoer. Laat de geautomatiseerde keten 15% van de producten over voor review, à 2 minuten per stuk, dan vraagt dezelfde levering 1,5 uur aandacht, plus het eenmalige werk van mapping en regels opzetten. Meet je eigen minuten per product voordat je begint, anders heb je niets om mee te vergelijken.
Zes manieren waarop geautomatiseerde productinvoer misgaat
- De leverancier hernoemt een kolom. "Prijs excl. btw" wordt "Nettoprijs" en de opgeslagen mapping slaat hem stilletjes over. Laat de import ongemapte kolommen melden en stop bij een ontbrekend verplicht veld.
- Een update overschrijft verrijkte tekst. De tweede levering vervangt je herschreven omschrijvingen door leverancierstekst. Beperk updates tot commerciële velden.
- Vrije-tekstattributen verzamelen spellingen. Laat je AI in een tekstveld schrijven in plaats van een keuzelijst, dan krijg je "rvs", "RVS" en "roestvrij staal" voor één materiaal.
- Publiceren draait voordat er regels zijn. Zet automatisch publiceren pas aan als de blokkerende regels staan.
- Matchen op een hergebruikte SKU. Twee producten uit verschillende series worden één record. Match op EAN als de artikelnummers van de leverancier niet stabiel zijn.
- Niemand is eigenaar van de uitzonderingen. Een reviewwachtrij die niemand leegmaakt, wordt een tweede achterstand. Wijs per leverancier één persoon aan.
Schonere bestanden beginnen met een data-afspraak per leverancier: de kolommen, eenheden, toegestane waarden en het barcodeformaat die je verwacht, verstuurd vóór de eerste levering. Het artikel over dirty data zet op een rij wat daarin hoort. WISEPIM brengt de stappen uit dit artikel samen: import met opgeslagen mappings, AI-extractie en webonderzoek, regels in Quality Guard en automatiseringen. Het gratis plan (100 producten) is genoeg om de import en AI-extractie op één leveranciersbestand te testen; Webonderzoek, automatiseringen en Quality Guard zitten in de betaalde plannen.